
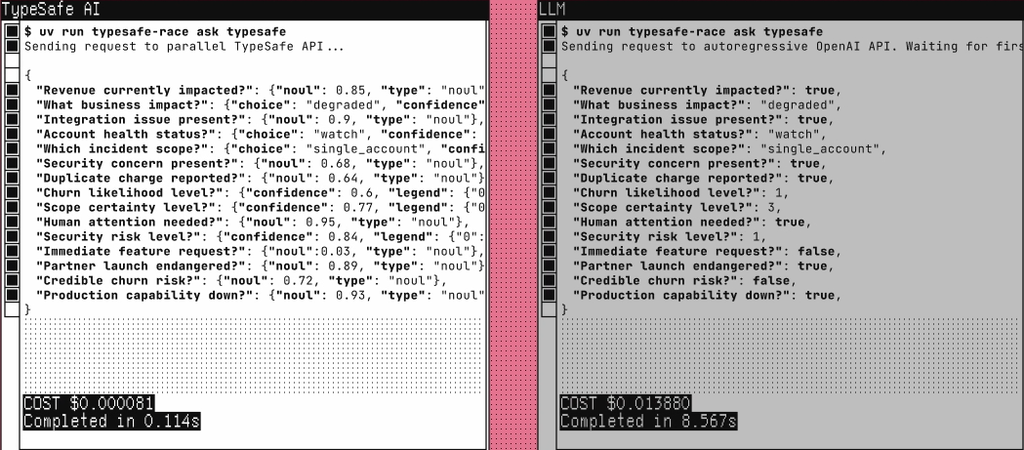
Se os LLMs tradicionais foram feitos para conversar, o JEV IA foi criado para decidir
Lançado em 15 de setembro de 2026 pela TypeSafe AI, startup do pesquisador Diogo Almeida (co-autor do InstructGPT e um dos nomes por trás do ChatGPT), o JEV é o primeiro modelo da categoria “System One”: uma IA que não gera texto, mas devolve decisões estruturadas e tipadas para serem usadas diretamente dentro de sistemas.
Para quem trabalha com automação, integrações e agentes de IA, isso muda o jogo: em vez de depender de um chatbot para “interpretar” e “responder”, você passa a ter um motor de decisão que classifica, escolhe e roteiriza com latência de milissegundos e custo drasticamente menor.
O que é o JEV IA e como ele funciona
O JEV IA não é um chatbot. Ele recebe contexto + perguntas pré-definidas e devolve opções escolhidas com probabilidades, tudo em formato estruturado (JSON), pronto para seu código consumir.
Em termos simples:
- Você define quais decisões o modelo deve tomar (ex.: “classificar lead”, “aprovar pedido”, “roteirizar ticket”).
- Informa as opções possíveis e um pequeno prompt por decisão.
O JEV retorna algo como:
{
  "decisions": [
    {
      "id": "classificar_lead",
      "choice": "quente",
      "confidence": 0.87,
      "probabilities": {
        "quente": 0.87,
        "morno": 0.11,
        "frio": 0.02
      }
    }
  ]
}/
Isso permite que seu sistema tome ações automáticas com base nessas decisões, sem precisar interpretar texto livre.
A grosso modo ele vai te ajudar na etapa Tool Calling!
Arquitetura System One do JEV IA
A TypeSafe chama o JEV de System One Model, em contraste com os LLMs (“System Two”). A ideia é:
- Focar em decisões restritas, não em geração aberta de linguagem.
- Usar amostragem paralela consciente de hardware para avaliar múltiplas hipóteses ao mesmo tempo.
- Treinar com Reinforcement Learning for Calibrated Decisions (RLCD), buscando decisões calibradas e menos “alucinações”.
O resultado, segundo a empresa, é um modelo que roda 20–200× mais rápido e custa 40–400× menos que LLMs de fronteira em tarefas de decisão.
Desempenho e custo do JEV IA
Dados oficiais do lançamento (todos vindos da própria TypeSafe; ainda sem auditoria independente ampla):
- Latência: entre 70 e 500 ms por decisão, dependendo da carga.
- Preço:
- US$ 0,042 por milhão de tokens de entrada
- Saída gratuita (não cobram tokens de resposta).
- Comparativos divulgados:
- Até 193,6× mais rápido e 444,6× mais barato que modelos conversacionais em certos fluxos testados pela própria empresa.
Em termos práticos, isso significa que você pode rodar milhares de decisões por hora com custo muito baixo, viabilizando automações em escala que antes eram proibitivas com LLMs tradicionais.
Casos de uso do JEV IA em automação
O JEV IA brilha em cenários onde você já sabe quais decisões precisa tomar e quer apenas mais inteligência e calibração nesse processo. Exemplos:
- Classificação de leads e oportunidades
- Decidir se um lead é “quente”, “morno” ou “frio” com base em histórico, comportamento e dados do CRM.
- Roteirização de tickets e solicitações
- Direcionar automaticamente chamados para o time/fluxo correto (suporte, vendas, financeiro) com confiança calibrada.
- Aprovação automática de pedidos e transações
- Aprovar, revisar ou bloquear pedidos com base em regras + contexto (valor, cliente, histórico, risco).
- Triagem de documentos e formulários
- Classificar tipos de documento, identificar inconsistências e decidir próximos passos (validar, solicitar complemento, rejeitar).
- Agentes de IA com módulo de decisão
- Usar o JEV como “cérebro decisório” dentro de agentes mais complexos, enquanto outros modelos cuidam de linguagem e interface.
Se o seu processo hoje usa regras fixas (if/else) ou depende de análise humana repetitiva, o JEV IA pode ser encaixado como uma camada de decisão probabilística entre seus dados e suas ações.
JEV IA vs LLMs tradicionais
| Critério | JEV IA (System One) | LLM tradicional (GPT, Claude, etc.) |
|---|---|---|
| Saída | Decisões tipadas + probabilidades (JSON) | Texto livre, código, conteúdo |
| Foco | Decisões dentro de software | Conversa, criação, raciocínio aberto |
| Latência típica | 70–500 ms | Segundos (dependendo do modelo e tarefa) |
| Custo (ordem de grandeza) | US$ 0,042 / milhão tokens entrada | US$ 0,20–10+ / milhão tokens (varia muito) |
| Ideal para | Automação, triagem, classificação, roteamento | Chatbots, redação, análise qualitativa, etc. |
Na prática, os dois são complementares: você pode usar um LLM para entender e estruturar a situação e o JEV IA para decidir o que fazer a seguir.